

KI-Parameter: Das Zusammenspiel von Temperature, Top-P und Presence Penalty einfach erklärt
KI-Parameter wie Temperature, Top-P und Presence Penalty bestimmen, wie ein Large Language Model (LLM) seine Ausgabe erzeugt. Generative KI und moderne Systeme künstlicher Intelligenz beruhen auf komplexen Modellen, die Text tokenweise generieren. Die Parameter beeinflussen, welche Token das Modell auswählt, wie vorhersehbar oder variabel der Output ausfällt und ob sich Wiederholungen einschleichen. Wer versteht, was diese Inferenzparameter bewirken, kann die Ergebnisse von ChatGPT, Claude, Mistral und anderen generativen KI-Modellen gezielter steuern – unabhängig davon, ob per API, Playground oder Prompt gearbeitet wird.
In diesem Beitrag erklären wir die wichtigsten KI-Parameter im Überblick, grenzen sie von gelernten Modellparametern ab und zeigen, welche Einstellungen zu welchem Anwendungsfall passen.
Kurz & Knapp
KI-Parameter wie Temperature, Top-P, Top-K und Penalties sind Inferenz-Einstellungen, die die Token-Auswahl bei LLMs beeinflussen – sie werden nicht im Training gelernt, sondern bei der Generierung festgelegt.
Temperature verändert die Wahrscheinlichkeitsverteilung aller Kandidat-Token; Top-P und Top-K begrenzen den Kandidatenpool auf unterschiedliche Weise.
Presence Penalty und Frequency Penalty reduzieren Wiederholungen – der erste greift ab dem ersten Auftreten eines Tokens, der zweite steigt mit jeder weiteren Verwendung.
Sinnvolle Parameterwerte hängen immer vom Modell, vom Anbieter und vom konkreten Anwendungsfall ab.
Was sind KI-Parameter bei LLMs?
Im Kontext generativer KI und großer Sprachmodelle (LLMs) unterscheidet man zwei Arten von Parametern:
Gelernte Modellparameter
Gelernte Modellparameter sind die internen Variablen eines KI-Modells – vor allem Gewichte und Verzerrungen in neuronalen Netzen –, die während des Trainingsprozesses aus den Trainingsdaten entstehen. In neuronalen Netzwerken bestimmen die Gewichte die Stärke der Verbindungen zwischen Neuronen: Jedes Neuron bildet aus der gewichteten Summe der Eingaben und einer Aktivierungsfunktion seine Ausgabe.
Neuronale Netze nutzen über viele Schichten hinweg (Deep Learning) diese Architektur, damit das Neural Network komplexe Muster in großen Datenmengen erfassen kann. Foundation-Modelle und große Modelle wie GPT-4 oder LLaMA wurden mit Milliarden von Parametern auf kuratierte Datensätze trainiert und können so Sprache verarbeiten, Klassifizierung vornehmen oder auch Vorhersagen in spezialisierten Anwendungsfällen treffen – von der Verarbeitung natürlicher Sprache über maschinelles Lernen bis hin zu Reinforcement Learning in simulierten Umgebungen.
Mehr Parameter ermöglichen grundsätzlich, dass KI-Modelle nuanciertere Zusammenhänge aus den Daten lernen, erhöhen aber auch das Risiko einer Überanpassung. In Regressionsmodellen sind die Parameter linear zugeordnete Koeffizienten, während sie in neuronalen Netzen eine hierarchische, nicht lineare Struktur bilden.
Die Leistung wird anhand von Metriken wie Genauigkeit, Präzision und Effizienz auf neuen Daten bewertet – entscheidend für die Validierung ist dabei die Robustheit gegenüber neuen Daten, die das Modell im Training nicht gesehen hat. Der Trend zu immer größeren Modellen mit mehr Parametern zeigt sich bei allen führenden Anbietern.
Inferenz- und Sampling-Parameter
Inferenz- und Sampling-Parameter wie Temperature, Top-P, Top-K, Presence Penalty und Frequency Penalty sind dagegen Einstellungen, die bei der Generierung von Text aktiv werden. Sie bestimmen, wie das Sprachmodell aus der berechneten Wahrscheinlichkeitsverteilung den nächsten Token auswählt. Diese Parameter lassen sich in APIs und Playgrounds direkt festlegen und optimieren – sie sind der Fokus dieses Beitrags.
Wichtig: Die Anpassung von Inferenzparametern verändert nicht das KI-Modell selbst. Anders als bei einer Feinabstimmung, die das Modell durch zusätzliches Training mit neuen Daten dauerhaft verändert, wirken Inferenzparameter nur auf die aktuelle Ausgabe. Auch Data Scientists, die Modelle für geschäftlich relevante Entscheidungsfindung trainieren, trennen klar zwischen gelernten Parametern und der Konfiguration bei der Anwendung.
Wie LLMs Token auswählen: kurz erklärt
LLMs erzeugen Text tokenweise. Für jede Position berechnet das Modell eine Wahrscheinlichkeitsverteilung über alle möglichen nächsten Token. Ein Token entspricht dabei einem Wort, einem Wortteil oder einem Satzzeichen – die genaue Aufteilung ist vom Tokenizer und der Sprache abhängig.
Ein vereinfachtes Beispiel: Auf den Satzanfang „Die schönste Stadt Deutschlands ist …" könnte ein Sprachmodell folgende Wahrscheinlichkeiten berechnen:
| Token | Wahrscheinlichkeit |
|---|---|
| München | 28% |
| Berlin | 22% |
| Hamburg | 18% |
| Heidelberg | 12% |
| Dresden | 8% |
| Bamberg | 5% |
| ... | ... |
Ohne Parameteranpassung wählt das Modell tendenziell den wahrscheinlichsten Token. KI-Parameter verändern genau diesen Auswahlprozess – sie formen die Verteilung oder begrenzen den Kandidatenpool, bevor ein Token ausgewählt wird.
Temperature, Top-P, Top-K und Penalties im Überblick
Bevor wir die einzelnen Parameter im Detail erklären, hier eine kompakte Vergleichstabelle:
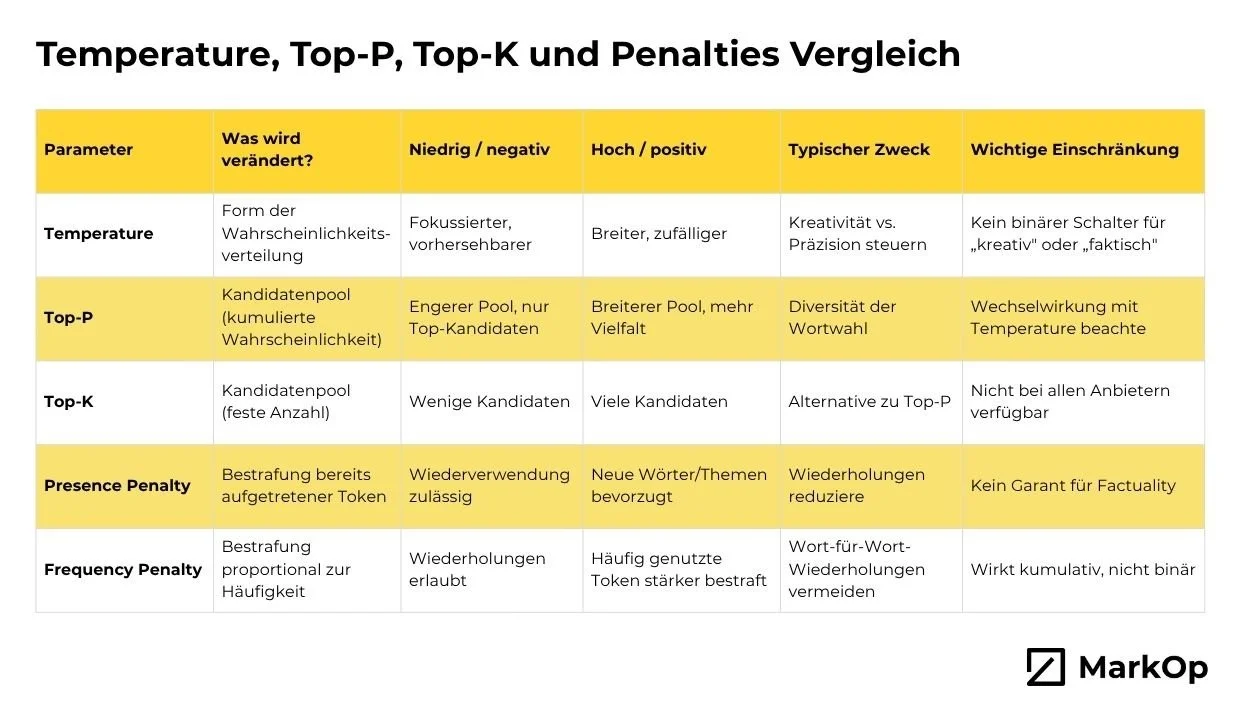
Eine barrierefreie PDF-Datei der Tabelle öffnet sich mit einem Klick auf das Bild und steht zum Download zur Verfügung.
Temperature
Temperature verändert die mathematische Form der Wahrscheinlichkeitsverteilung über die möglichen Kandidaten-Token.
Eine niedrige Temperature, beispielsweise 0,2, macht die Verteilung „spitzer“. Der wahrscheinlichste Token dominiert stärker, wodurch die Ausgabe vorhersehbarer und fokussierter wird. Zudem fallen die Unterschiede zwischen mehreren Durchläufen geringer aus. Diese Einstellung eignet sich besonders für faktische Zusammenfassungen, Klassifizierungen und die Extraktion von Daten.
Eine hohe Temperature, beispielsweise 1,2, flacht die Verteilung ab. Dadurch erhalten weniger wahrscheinliche Token eine größere Chance, ausgewählt zu werden. Die Ausgaben werden variabler und überraschender und können zwischen einzelnen Durchläufen stärker schwanken. Das bietet sich vor allem für kreative Texte, Brainstormings und die Entwicklung neuer Ideen an.
Temperature steuert jedoch nicht „die Kreativität“ als eigenständige Eigenschaft eines KI-Modells. Der Parameter beeinflusst lediglich die Wahrscheinlichkeit, mit der das Modell seltenere Token auswählt. Das Ergebnis wirkt kreativer, weil sich dadurch der tatsächlich berücksichtigte Kandidatenraum vergrößert.
Top-P (Nucleus Sampling)
Top-P begrenzt den Kandidatenpool dynamisch: Es wird die kleinste Menge an Token betrachtet, deren kumulierte Wahrscheinlichkeit den gewählten p-Wert erreicht oder überschreitet. Bei Top-P = 0,5 werden im obigen Beispiel nur „München" und „Berlin" als Kandidaten berücksichtigt, da ihre Wahrscheinlichkeiten zusammen bereits 50 % erreichen.
Ein niedriges Top-P (z. B. 0,3) führt zu einem sehr engen Kandidatenpool und damit zu vorhersehbaren, fokussierten Ergebnissen. Ein hohes Top-P (z. B. 0,95) berücksichtigt einen breiteren Pool und ermöglicht vielfältigere Formulierungen.
Top-K
Top-K verfolgt ein ähnliches Ziel wie Top-P, arbeitet aber mit einer festen Anzahl statt mit einer Wahrscheinlichkeitsschwelle. Bei Top-K = 3 werden nur die drei wahrscheinlichsten Token als Kandidaten zugelassen – unabhängig davon, wie ihre Wahrscheinlichkeiten verteilt sind.
Der Unterschied zu Top-P: Top-K ist statisch (immer genau K Kandidaten), während Top-P sich dynamisch an die aktuelle Verteilung anpasst. In der Praxis lassen sich beide kombinieren, viele Anbieter unterstützen jedoch nur einen der beiden Parameter.
Presence Penalty
Die Presence Penalty bestraft Token, die im bisherigen Output bereits mindestens einmal aufgetaucht sind. Eine positive Presence Penalty erhöht die Chance, dass das Modell neue Wörter und Themen einführt. Eine negative oder auf 0 gesetzte Presence Penalty erlaubt dem Modell, dieselben Token erneut zu verwenden.
Presence Penalty ist kein Halluzinations-Regler. Eine höhere Penalty kann zwar thematische Vielfalt fördern, sie sorgt aber nicht dafür, dass die generierten Inhalte faktisch korrekt oder weniger verzerrt sind. Die Genauigkeit und Robustheit der Ausgabe hängen von der Qualität des Modells, den Trainingsdaten und den Eingaben ab – nicht von einem einzelnen Parameter.
Frequency Penalty
Die Frequency Penalty arbeitet ähnlich wie die Presence Penalty, greift aber proportional zur Häufigkeit: Je öfter ein Token bereits im Output vorkommt, desto stärker wird er bestraft. Während Presence Penalty binär wirkt (Token kam vor oder nicht), steigt Frequency Penalty mit jeder weiteren Verwendung.
In der Praxis eignet sich Frequency Penalty besonders bei langen Ausgaben, in denen Wiederholungen von Formulierungen oder Phrasen zum Problem werden können.
Temperature vs. Top-P: Was ist der Unterschied?
Dieser Vergleich gehört zu den häufigsten Fragen rund um LLM-Parameter. Beide beeinflussen die Variabilität des Outputs, aber auf unterschiedliche Weise:
| Aspekt | Temperature | Top-P |
|---|---|---|
| Mechanik | Verändert die Form der Verteilung (alle Token betroffen) | Schneidet den Kandidatenraum ab (nur Token oberhalb der kumulierten Schwelle) |
| Auswirkung | Beeinflusst, wie stark der wahrscheinlichste Token dominiert | Bestimmt, wie viele Token als Kandidaten zur Auswahl stehen |
| Analogie | „Wie spitz oder flach ist die Kurve?" | „Wie breit ist der Trichter?" |
Die OpenAI-Dokumentation empfiehlt, üblicherweise Temperature oder Top-P zu verändern, nicht beide gleichzeitig – das ist eine provider-spezifische Empfehlung, die nicht für alle LLMs und APIs gelten muss.
Top-P vs. Top-K in Kürze: Top-P passt den Kandidatenpool dynamisch an die aktuelle Verteilung an, Top-K arbeitet mit einer fixen Anzahl an Kandidaten. In vielen Anwendungsfällen liefert Top-P flexiblere Ergebnisse, weil es auf die tatsächliche Verteilung reagiert.
Welche Einstellungen passen zu welchem Anwendungsfall?
Es gibt keine universellen Idealwerte. Die optimale Konfiguration hängt vom Modell, vom Anbieter und von der konkreten Aufgabe ab. Statt fixer Presets arbeitet ihr besser mit Tendenzen:
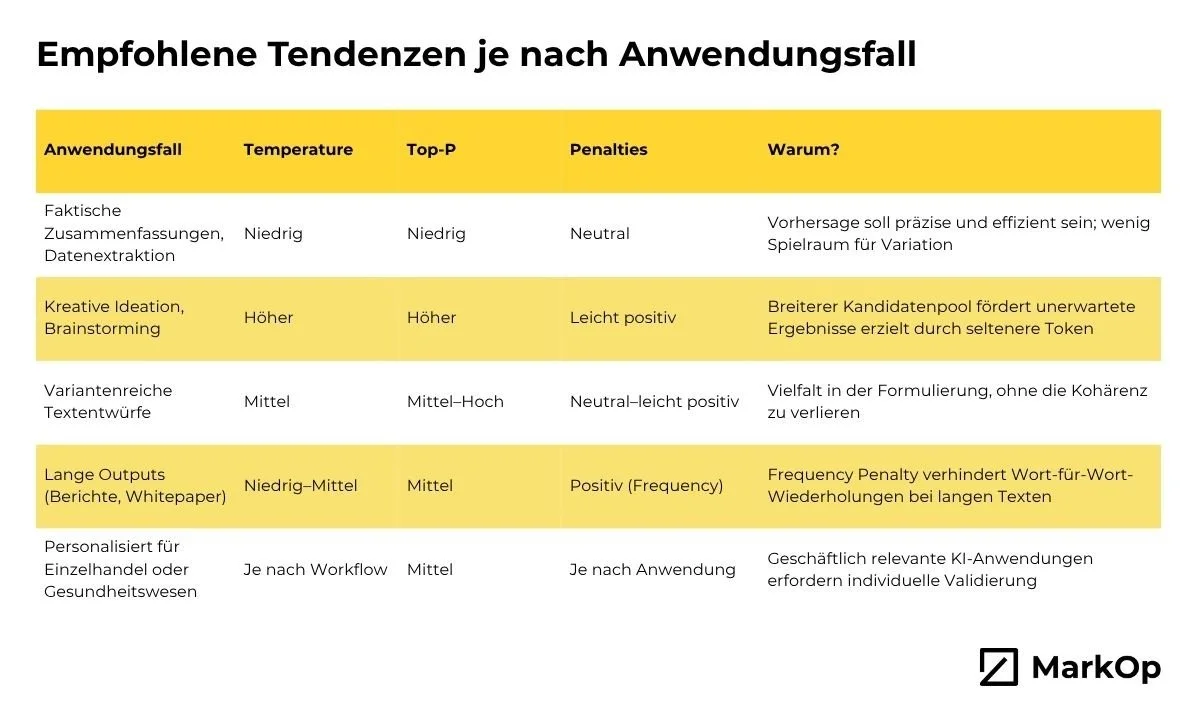
Eine barrierefreie PDF-Datei der Tabelle öffnet sich mit einem Klick auf das Bild und steht zum Download zur Verfügung.
Wichtig: Prompts und Parametersteuerung sind zwei verschiedene Ebenen, die zusammenwirken, aber nicht dasselbe sind. Ein guter Prompt mit Fachwissen definiert, was das Modell tun soll; Parameter bestimmen, wie das Modell aus seinem gelernten Wissen auswählt. Beides lässt sich kombinieren, aber Prompt-Anweisungen wie „sei kreativ" setzen keine technischen Parameterwerte.
Wo lassen sich KI-Parameter einstellen?
Nicht in jeder Umgebung und nicht bei jedem KI-Modell lassen sich dieselben Parameter direkt einstellen. Welche Optionen verfügbar sind, hängt von der jeweiligen Oberfläche, dem Anbieter und dem verwendeten Modell ab.
ChatGPT
In der Benutzeroberfläche von ChatGPT können Temperature, Top-P und Penalties nicht direkt konfiguriert werden. Prompts können das Antwortverhalten zwar beeinflussen, legen jedoch keine konkreten Parameterwerte fest.
OpenAI Playground und API
Im OpenAI Playground und über die API lassen sich unter anderem Temperature, Top-P, Presence Penalty und Frequency Penalty einstellen.
Allerdings unterstützt nicht jedes Modell sämtliche Parameter. Insbesondere bei Reasoning-Modellen können Einschränkungen gelten. Deshalb solltest du vorab die Modellkompatibilität prüfen.
Anthropic Claude API
Die Claude API von Anthropic bietet Einstellungsmöglichkeiten für Temperature, Top-P und Top-K. Separate Frequency und Presence Penalties stehen hingegen nicht zur Verfügung.
Google Gemini API
Über die Gemini API lassen sich Temperature, Top-P und Top-K konfigurieren. Die verfügbaren Wertebereiche und Standardeinstellungen unterscheiden sich je nach Modell.
Mistral API
Bei der Mistral API kannst du unter anderem Temperature und Top-P festlegen. Abhängig vom ausgewählten Modell können weitere Parameter verfügbar sein.
Lokale KI-Modelle
Lokale Lösungen wie Ollama und LM Studio bieten umfassende Kontrolle über die gängigen Sampling-Parameter. Ihre Nutzung setzt allerdings ein entsprechendes technisches Setup voraus.
Fazit
Temperature, Top-P, Top-K, Presence Penalty und Frequency Penalty steuern unterschiedliche Aspekte der Token-Auswahl bei LLMs. Temperature formt die Verteilung, Top-P und Top-K begrenzen den Kandidatenpool, und Penalties reduzieren Wiederholungen. Wie effektiv diese Einstellungen wirken, hängt vom verwendeten Modell, dem Anbieter und dem konkreten Anwendungsfall ab.
Wer das Zusammenspiel der Parameter versteht, kann LLM-Ausgaben gezielter steuern – gerade in professionellen Workflows, in denen konsistente oder bewusst variierende Ergebnisse gefragt sind. Entscheidend bleibt aber: Parametersteuerung und gutes Prompting ergänzen sich, ersetzen sich aber nicht gegenseitig.
Häufig gestellte Fragen zum Thema KI-Parameter
Sollte man Temperature und Top-P gleichzeitig verändern?
Die OpenAI-Dokumentation empfiehlt, üblicherweise nur einen der beiden Parameter anzupassen, da sie sich gegenseitig beeinflussen. In der Praxis hängt es vom Modell und Anbieter ab: Einige APIs erlauben die Kombination, andere nutzen intern nur einen der beiden Werte. Testet die Auswirkungen auf euren konkreten Anwendungsfall, bevor ihr beide gleichzeitig verändert.
Sind KI-Parameter dasselbe wie Modellparameter?
Nein. Modellparameter sind die gelernten Gewichte und Verzerrungen eines neuronalen Netzes – sie entstehen während des Trainingsprozesses und definieren, was das Modell „weiß". Inferenzparameter wie Temperature oder Top-P sind externe Einstellungen, die steuern, wie das Modell zur Laufzeit aus seinem Wissen auswählt. Die Anzahl der Modellparameter beeinflusst die Kapazität des KI-Modells; Inferenzparameter beeinflussen die Ausgabequalität bei der Generierung.
Gelten dieselben Parameterwerte bei allen LLMs und APIs?
Nein. Parameterbereiche, Defaults und unterstützte Parameter unterscheiden sich je nach Anbieter (OpenAI, Anthropic, Google, Mistral) und Modell. Ein Temperature-Wert von 0,7 kann bei verschiedenen KI-Modellen unterschiedliche Ergebnisse erzielt haben. Prüft immer die aktuelle Dokumentation des jeweiligen Anbieters und testet Einstellungen modellspezifisch.
Warum liefert ein LLM trotz gleicher Einstellungen nicht immer exakt dieselbe Antwort?
Selbst bei Temperature = 0 kann es zu minimalen Abweichungen kommen. Das liegt an technischen Faktoren wie numerischer Präzision bei der Verarbeitung natürlicher Sprache, GPU-Parallelisierung und internen Optimierungen der Algorithmen. Bei höheren Temperature-Werten sind Abweichungen gewollt – die Wahrscheinlichkeitsverteilung lässt bewusst Variation zu. Vollständige Reproduzierbarkeit ist bei den meisten LLMs und APIs nicht garantiert.
